ある研究者の学説を最初に唱えた論文はどれか。著者がChatGPTにそう尋ねると、具体的な論文名と該当箇所を添えた回答が返ってきました。念のため引用文そのものを出力させると、いかにも本物らしい一文がすらすらと生成されます。
ところが原著を取り寄せて確かめると、そんな記述はどこにも見当たりませんでした。学説が実際に登場したのは、AIが挙げた論文よりも5年もあとに書かれた、まったく別の一本だったのです。
AI開発の最前線に立つ研究者本人が、AIの捏造にまんまと引っかかった。それを著者自身が正直に明かしているところに、この本の信頼度が表れています。
もっともらしい嘘を、これほど流暢につくAIが、なぜここまで賢く見えるのか。その仕組みを数式抜きで解き明かすのが、岡野原大輔さんの『大規模言語モデルは新たな知能か』です。
著者はPreferred Networksの共同創業者であり最高研究責任者。日本のAI開発を長く牽引してきた立場です。その人物が新書サイズの一冊で、次の単語を予測するだけの技術がなぜ意味を理解しているように見えるのか、なぜ嘘をつくのか、人間とは何が違うのかを、専門用語を削りながらも中身を薄めずに書き切っています。
ChatGPTは2022年11月の公開からわずか2か月で、利用者が1億人を突破しました。同じ水準に達するまでTikTokは9か月、Instagramは2年5か月を要しています。
この普及速度が、書店に二種類の本を生みました。プロンプトの使い方をまとめた実用書と、AIが人類を脅かすかどうかを煽る未来予測書です。本書はそのどちらでもなく、開発者の目線で「中で何が起きているか」だけを語る一冊です。
刊行は2023年半ばで、その後のマルチモーダル化やエージェント技術の広がりは扱っていません。それでも、なぜLLMが機能するのかという土台の説明は、いま読んでも古びていません。読み終えるころには、ChatGPTに向き合うときの構えそのものが変わっているはずです。
「次の単語当て」だけで、なぜ意味が宿るのか
LLMが内部でしていることは、突き詰めればひとつです。それまでの単語の並びから、次に続く確率が最も高い単語を選ぶ。ただそれだけを、猛烈な回数繰り返しています。
この発想の源流は1948年、情報理論を打ち立てたクロード・シャノンにさかのぼります。シャノンはメッセージの「意味」をいったん脇に置き、その事象がどれだけ起こりにくいかという確率だけで情報量を定義し直しました。
ここで多くの人が引っかかります。確率で単語を並べているだけなら、AIは意味など理解していないはずだ、と。本書の答えは逆です。次の一語をわずかでも正確に当てようとすると、文脈のつながりや文法、言葉の背景にある常識まで動員しないと精度が出ません。
予測の精度をひたすら追い込んだ結果として、意味を扱う能力が副産物のように育ってしまった。意味を捨てて確率だけを追いかけた先に、意味そのものが立ち上がってきたわけです。
この学習を支えるのが自己教師あり学習です。文章の一部を隠し、周囲の文脈から埋め戻す練習を、正解ラベルなしに繰り返す。人が一枚ずつ「これは犬」「これは猫」と教える必要がなく、世の中にあるテキストの量だけ、練習問題がタダで手に入ります。
データを人手で選別しなくてよい、というこの一点が、後述する規模の拡大を可能にした土台になっています。
投資額から性能を逆算できる時代になった
技術的な飛躍の裏には、地味だけれど大きな発見があります。2020年1月、ジョンズ・ホプキンス大学とOpenAIの研究チームが、学習データの量・パラメータ数・計算量を増やすほど、モデルの誤り率が対数グラフ上できれいな直線を描いて下がっていく規則性を報告しました。
これが「スケーリング則」です。
意味は大きい。学習を始める前から、投資額に応じた性能をかなりの精度で見積もれるようになったということです。開発費が読めない賭けから、電卓を叩ける投資に変わりました。
しかも、モデルを大きくするほど訓練データを丸暗記して未知の問題に弱くなる、という従来の機械学習の常識まで覆します。LLMでは規模を上げるほど、むしろ未知の問いへの対応力も上がっていくのです。
数字の推移を追うと実感が湧きます。2018年のGPT-1は学習データ4.5ギガバイト、パラメータ1.2億でした。2020年のGPT-3では570ギガバイト、1750億パラメータまで膨らみ、2年で規模が100倍以上に跳ね上がっています。
57分野の知識を問う総合テストでも、GPT-2の正答率32.4%からGPT-4は86.4%まで伸び、各分野の専門家の平均スコア89.8%にほぼ並ぶところまで来ました。
ただし、この恩恵を受け取れるのは一部の企業だけです。最先端のLLMを一度訓練する計算量は天文学的な規模で、GPT-4だけで140億円以上の開発費が投じられたと、OpenAIのCEO自身が明かしています。
試行錯誤を含めた総額はその数倍にふくらむ。スケーリング則が生んだ「投資すれば性能が読める」という果実は、その投資を賄える一握りの企業にしか手が届きません。
賢さは階段のように飛躍する
ところが、あらゆる能力がなめらかに伸びるわけではありません。次の単語を当てる基礎性能は着実に上がる一方、翻訳や算数、論理パズルといった応用課題の成績は、パラメータ数が数十億から100億程度の段階までほとんど解けないままです。
それが数百億、数千億という規模の壁を越えた途端、急に解けるようになる。この非連続な飛躍を創発と呼びます。
なぜ階段状に飛ぶのかは、本書も完全には解明されていないと認めています。有力な説明のひとつが「圧縮」という捉え方です。世界の情報をより短く圧縮できるということは、その分だけ世界の構造を理解できているということでもある。
圧縮率のわずかな改善が、応用能力の急激な飛躍として表に出てくる、という見立てです。
賢さが連続的に育つのではなく、ある日突然、質的に変わる瞬間がある。この一点だけでも、AIの性能を線を引くように予測してはいけないという教訓になります。手元のAIが急に賢くなったように感じる瞬間があるとすれば、それは錯覚ではなく、この階段の一段を越えた合図かもしれません。
学ばずに学んだふりをする、その場しのぎの学習
ChatGPTに役割を与えたり、例をいくつか見せたりすると、そのやり方を真似て答えを返してきます。本文中学習と呼ばれる現象です。直感的には、対話のあいだにモデルの中身が書き換わっているように見えます。
でも実際は違います。利用中のLLMは、脳のシナプスに相当するパラメータを一切変更していません。本書は、自己注意機構の計算式を数学的に変形すると、プロンプト中の例から生じる予測誤差をもとにパラメータを一時的に急更新したときと、同じ計算結果を再現できることを示します。
つまり実際には固定されたまま、更新したのと同じ効果だけをその場でシミュレートしているのです。
現象の報告だけで終わらず、なぜそうなるかを数式のレベルまで遡って説明する。この踏み込みの深さこそ、他の入門書と一線を画す部分だと感じました。
嘘の正体と、それでも人に寄り添わせる技術
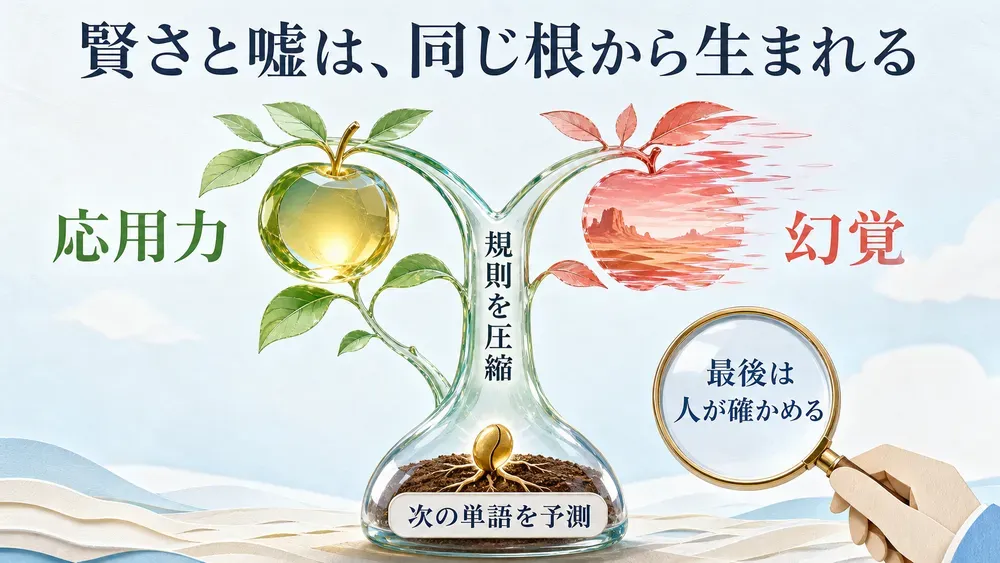
冒頭の、著者自身が偽の引用に騙された話に戻ります。LLMは事実をデータベースのように固定して記憶しているわけではありません。文脈上もっともらしい単語を合成しているだけなので、存在しない論文や法律を、悪気なく、しかも流暢に作り出してしまう。これが幻覚と呼ばれる現象です。
新しい知識を覚える過程で古い記憶が混ざり合う破滅的忘却も、もっともらしい嘘を後押しします。厄介なのは、この弱点が未知の問いに対応する力、いわば汎化能力と同じ根から生えていることです。技術だけで完全に断ち切るのは難しく、本書もこれにはまだ時間がかかると見ています。
だからこそ、次の単語を当てるだけに特化した学習直後のモデルは、そのままでは使い物になりません。人間の意図を無視した発言も平気で出します。ChatGPTが実用に耐えているのは、良い回答をまず模倣させ、人間による評価の順位づけから報酬の基準をモデル化し、その基準で高得点を取る方向へパラメータを調整し直す、三段階の訓練を経ているからです。
囲碁AIの強化学習と骨格を同じくする手法が、対話にも応用された形です。
脳とAI、埋まらない一点
では、この新しい知能は人間に近づいたのでしょうか。本書が挙げる数字は容赦がありません。人間の脳はニューロンが約1000億個、シナプスは推定1000兆個。
対して最大級のLLMのパラメータは1兆規模にとどまり、接続の複雑さでは脳がなお上回ります。消費電力の差はさらに極端です。発電所級の電力を要するLLMに対し、感情も身体制御も担う人間の脳はわずか20ワット、電球1個分で動いています。
それでも、テキストしか読んでいないはずのLLMが、空間や物理の構造を扱えるようになっている事実は残ります。カメラもセンサーも持たないのに、数千次元の内部空間へ概念どうしの距離関係を組み立てただけで、それなりに筋の通った推論を返してくる。
身体を通した経験がなくても、言葉の集積だけから世界のかたちをある程度言い当ててしまう。ここは素直に驚くべきところです。
一方で、埋まらない差もあります。人が語れることの背後には、語られないまま積み重なった経験知があります。LLMが学べるのは、言葉になった部分だけです。
労働への影響を試算した章では、米国労働者の8割が業務の一部でAIの影響を受け、2割近くは業務の半分以上に影響を受けると推計されています。それでも本書が「仕事がなくなる」と言い切らないのは、AIが出力の結果に責任を持てないからです。
判断と責任の最後の一片は、当面、人間の持ち場として残ります。
この技術との付き合い方を、本書は「何でも言うことを聞いてくれる万能の相談役」としてではなく、「博識だが、ときどきもっともらしい嘘をつく、少し変わった同僚」として捉え直すよう促します。
固有名詞や数字を鵜呑みにせず裏を取る。役割と制約を渡してから頼む。冒頭の著者自身が味わった苦い経験を思い出すたびに、この二つの習慣がどれだけ効くかを実感できるはずです。
