「ChatGPTって結局どういう理屈で動いてるの」と後輩に聞かれて、答えられなかった。そういう人は少なくないはずだ。毎日使いこなしていても、中身を説明できるかどうかは別の話になる。
その空白を埋めてくれるのが、中西崇文さんによる一冊だ。武器にするのはベクトルと行列という、高校の数学で一度は習う2つの概念だけ。東京工科大学でコンピュータサイエンスを教える著者が、大学院での講義資料を土台に書き上げた。
読み終えたときに起きるのは、評価の逆転だ。ChatGPTを賢いと思いすぎていた部分と、原理を知らないまま見くびっていた部分が、両方まとめて修正される。数式が苦手でも読み通せるよう、説明の順序が丁寧に組まれている点も本書の美点だ。
「もっともらしい次の一語」という身も蓋もない定義
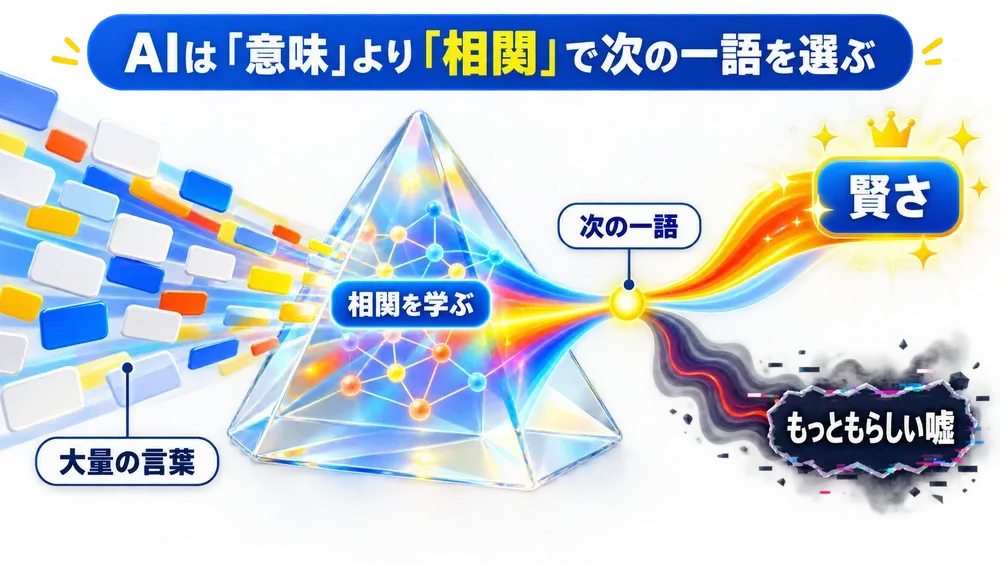
本書が置く定義は拍子抜けするほどそっけない。大量の文章を読み込んだ末に、次に続く確率が一番高そうな一語を選び続けているだけ、というのがその中身だ。「昨日、布団で」の続きに「寝る」を当てる。その種の予測を、単語ひとつぶんずつ、延々と機械的に繰り返している。
「『膨大なデータをもとに、もっともらしい次の一語を提示する』これこそがChatGPTの基本機能です。」
この力を育てる過程は二段階に分かれる。最初の段階では、ウェブ上の文章を大量に読ませ、次に来る単語を当てるクイズを解かせ続ける。ここで文法や一般常識、コードの書き方までが自然と身についていく。
次の段階では、人間による評価を報酬に見立てて振る舞いを調整していく。乱暴な返答が減っていくのは、接客業がマナーを叩き込まれる過程に近い。
LLM(大規模言語モデル)を、著者は巨大なレシピ集にたとえている。大量の料理本とデータから編まれたレシピ集であって、ChatGPTは料理人の側ではなく、あくまでレシピ集そのものだという見立てだ。
りんごを数値にする——ベクトルという発想
日本語をそのまま扱えないコンピュータは、まず言葉や物事を数値の列に翻訳する。この数値の列がベクトルだ。
題材に選ばれているのはりんごである。重さと赤みと糖度、この3つの数値を並べるだけで、りんご1個を3次元のベクトルとして扱える。数値化のために選んだこの要素のことを、特徴量と呼ぶ。
似ている・似ていないを判定する道具がコサイン類似度だ。2つのベクトルが指す方向にどれだけズレがないか、その角度を数値に落とし込む。本書はここで、この計算があっけなく壊れる例も見せてくれる。
身長や体重のように桁の大きい数値と、5段階評価のように桁の小さい数値を混ぜて類似度を測ると、どの組み合わせも0.99前後に張り付いてしまい、区別がまったくつかなくなった。
桁の大きい特徴量が、計算全体を乗っ取ってしまうのだ。そのためベクトルの長さをそろえ直す正規化という処理を挟むと、同じデータの類似度が0.0から0.83付近まで散らばり、はじめて意味のある比較になる。
言葉を数値化する古い手法としてBag-of-Wordsも紹介される。ある単語が出現すれば1、出現しなければ0という単純な仕組みで、英語辞書に載る見出し語が2197語だけなら、その2197語の有無を並べるだけで、どんな文章も2197次元のベクトルに変換できる。
弱点は、「クビ」が首なのか解雇なのかまでは区別できない点にある。0か1かしかない世界の限界だ。
この壁を破ったのが2013年公開のword2vecというモデルだ。ある単語がどんな単語と一緒に使われやすいかという共起の傾向を大量の文章から学ばせると、単語を空間上の点として並べたとき「女王-女+男=王」のような足し算引き算が成り立つようになった。
Googleが2018年に世に出した後継のBERTは、この発想に文脈という要素を組み込み、同じ「クビ」という語でも前後の文脈しだいで別のベクトルとして扱えるようにした。
効果は数字にも表れていて、単数形と複数形を別単語として扱っていた初期の検索エンジンでは無関係と判定されていた「person」と「people」の関連度が、文脈を織り込んだこの方式では0.8から0.9台まで引き上がっている。
行列は「広げて、絞る」ための道具
ベクトルの次に登場するのが行列だ。本書はこれを、次元を伸縮させるレンズとして扱う。増やせば表現が細かく豊かになり、減らせばスッキリとまとまる。
実例として使われるのがBMIの計算だ。身長165センチ・体重55キロという2つの数値の組に、ある1行2列の行列を掛けるだけで19.17という数値が出てくる。
実際のBMIは20.20。もう一人、身長170センチ・体重65キロの例では22.70に対して実際は22.49。BMIの計算式にはまったく頼らず、行列の掛け算のみで近い値にたどり着いている。
「AIは大量のデータを使って『ちょうどよい行列』を簡単に見つけ出すことができます。このプロセスこそが、一般に『学習』や『訓練』と呼ばれるものです。」
次元は多ければ多いほど良いわけでもない。増やしすぎると、あらゆるデータの類似度が横並びになって判別できなくなる次元の呪いが起きるため、絞る操作と組み合わせて使う必要がある。
この「広げて、絞る」構造を積み重ねたものがニューラルネットワークだ。本書はじゃんけんを教材に、グー・チョキ・パーを3次元で入力し、中間層で6次元に広げてから、出力層で3次元に絞り込む例を見せる。
グーを入れると、出力はほぼ完全にパーを選ぶスコアになる。ルールを一行も書いていないのに、である。この行列の中身を鍛え上げる仕組みがバックプロパゲーション、日本語でいう誤差逆伝播法である。
出力と正解とのズレを、出力に近い側から入力に近い側へさかのぼらせながら、各層の数値を少しずつ補正していく。活性化関数と呼ばれる部品も途中に挟まり、これがあるおかげでネットワークは直線的な判断から抜け出せる。
Transformerは論理を捨て、相関だけで動く
『Attention Is All You Need』という2017年の論文が、Googleの研究者8名によってTransformerを世に送り出した。
やっていることを一言でいえば、文中の単語同士がどれくらい関係していそうかを総当たりで計算し、その結果から次の一語を確率的に決めること。Self-Attentionという仕組みでは、同じ文からQ・K・Vという3種類の行列を作り、掛け算と足し算と正規化を重ねて「どこに注目すべきか」の確率分布を導く。
本書のサンプルプログラムは、好きな食べ物としてラーメンを挙げる一文をBERTに通す実験を載せている。Attentionの結びつきをヒートマップにすると、「ラーメン」という語が同じ文中の「食べ物」という語ともっとも濃く結びついている様子が、色の濃淡として目に見える。
この仕組みが見ているのは文章の意味や論理ではなく、似た並びが学習データの中でどれだけ繰り返し出てきたかという頻度の傾向にすぎない。だからこそハルシネーションが起きる。事実かどうかを検証する部品がそもそも構造に組み込まれていない以上、性能を上げたところで解消しない性質の欠陥だ、というのが本書の見立てである。その代わりに手に入れたのが汎用性で、同じ骨格に文章・楽譜・絵画という違う素材を注ぎ込むだけで、まったく別ジャンルの生成AIへと化ける。著者はこれを万能の万年筆にたとえている。
エキスパートシステムに代表される第2次AIブームの方式は、判断のルールを人間がひとつずつ手で書き込むものだった。Transformerはその対極を選び、ルールを書く代わりに、大量の事例から相関だけを吸い上げる道を選んだ。
明日からできること
AIに何かを尋ねたら、根拠と検証ステップも一緒に出すよう付け足して聞く。ハルシネーションが仕組み上ゼロにならない以上、裏取りの工程を最初から会話に組み込んでおくほうが確実だ。
本書のサンプルコードは出版社のサイトから入手でき、無料アカウントがあれば使えるGoogle Colaboratory上でそのまま再現できる。Attentionを計算するセルを実際に走らせて、自分で書いた一文がどんなヒートマップになるかを一度見ておくと、ここまでの数式が急に手触りのあるものに変わる。
ノートを見開きで使い、左のページに要因やアイデアを数十個書き出し、右のページで本質的な数個まで畳み込む。著者が提案する、ニューラルネットワークの「広げて、絞る」という構造を思考の型に転用するやり方だ。
次にChatGPTへ何かを尋ねるとき、返ってきた文章を「その時点でもっとも確率が高かった単語の並び」として眺め直してみてほしい。それだけで、質問の立て方も、答えの受け止め方も変わってくる。
合わせて読みたい
近い問題意識を扱う3冊を挙げておく。
『シン読解力』新井紀子(記事はこちら) 意味を理解する部品を持たないまま言葉を操っているとわかった今、最後に効いてくるのは読み手側の理解力だ。本書のあとに開くと、新井さんが鳴らしてきた警鐘の切実さがまるで違って響いてくる。
『対話するたび成長する AIセルフ・コーチング』渡邊佑(記事はこちら) 答えを右から左へ受け取るだけの使い方から、ChatGPTを一度引き剥がしてくれる一冊。頻度の相関を追っているだけの相手と、それでもどう対話を組み立てるかという実践編にあたる。
『生成AI時代を勝ち抜く事業・組織のつくり方』梶谷健人(記事はこちら) 会社という単位で描いた地図にあたるのがこちらだ。個人の理解を扱う本書に対して、原理を掴んだ人間が次に組織の中で何から手をつけるかを考える段になったら開きたい。